Medir es construir la evidencia más creíble posible
Por Manuel Barrantes
CEO & Fundador de Reach HR Group
En una conversación reciente que tuve con un director del área de Talento, surgió una objeción que he escuchado varias veces y que, en el fondo, me parece completamente razonable: «¿para qué invertir tanto esfuerzo en medir el impacto de un programa de liderazgo, si el desempeño de un equipo depende de tantas otras variables -rotación, condiciones de mercado, decisiones de otras áreas del negocio- que aislar lo que aportó específicamente la capacitación es prácticamente imposible?»
Un obstáculo real, no una excusa
Es una objeción legítima, no una forma de evadir responsabilidad. El desempeño organizacional responde a causas simultáneas, y ningún programa de liderazgo opera en un laboratorio con las demás variables controladas. Si un equipo de ventas mejora sus resultados después de un programa de liderazgo, es honesto preguntarse cuánto de esa mejora corresponde al programa y cuánto a un mercado más favorable, a un cambio de compensación, o simplemente a la salida de una persona que no rendía.
El problema no está en hacerse esa pregunta sino en la conclusión que muchos equipos terminan sacando de ella: dado que la atribución perfecta es compleja de lograr, no vale la pena intentar una medición rigurosa, y basta con reportar satisfacción, asistencia o nivel de aprendizaje. Es una decisión comprensible ya que evita el riesgo de presentar evidencia imperfecta ante el negocio, pero deja a los equipos de Talento sin argumentos cuando llega la revisión de presupuesto o sostener las iniciativas de desarrollo en el tiempo.
Lo que aporta la evidencia
Jaason Geerts (2024), investigador de la Canadian College of Health Leaders y de la University of Cambridge, publicó en la revista científica Behavioral Sciences un marco integrador construido sobre tres revisiones sistemáticas de desarrollo de liderazgo (172 estudios empíricos entre los años 2000 y 2020) y una revisión adicional sobre transferencia del aprendizaje en el puesto.
Dentro de ese marco, el «Optimizing System», la categoría dedicada a evaluación no intenta resolver el problema de la atribución con una fórmula mágica. Lo que propone, a partir de los estudios de mejor calidad metodológica revisados, es un conjunto de decisiones de diseño que fortalecen sustancialmente la credibilidad de una afirmación de impacto: medir tanto el programa como los resultados del participante; combinar datos cuantitativos y cualitativos, objetivos y subjetivos; recoger información de más de un evaluador (el propio participante, pares, el facilitador y el supervisor directo); incorporar, cuando sea viable, un grupo de comparación que no participó del programa y medir en al menos tres momentos (línea base, cierre y un seguimiento posterior) en lugar de solo dos.
Ninguno de estos elementos, por separado, resuelve el problema de causalidad. Juntos, construyen lo que en investigación se llama «triangulación»: si varias fuentes independientes de evidencia apuntan en la misma dirección, la probabilidad de que el cambio observado se explique únicamente por factores externos al programa se reduce de forma significativa, aunque casi nunca llegue a cero.
La distinción que cambia el diseño
Es por eso que sobre un enfoque de «no podemos aislar el efecto del programa de otros factores, así que nos limitamos a medir satisfacción y participación” prefiero plantear un enfoque de «no podemos aislar el efecto del programa por completo, pero sí podemos fortalecer la evidencia en conjunto”.
La primera frase convierte una limitación real en una razón para no medir. La segunda la convierte en un criterio de diseño: qué evidencia adicional se puede sumar, sabiendo de antemano que ninguna prueba será perfecta pero en la medida que sumemos evidencias como por ejemplo un grupo de comparación, más de un evaluador, y mediciones en tres momentos distintos podemos dar solidez a nuestros argumentos sobre el impacto de nuestros programas.
Cómo trasladamos esto al diseño
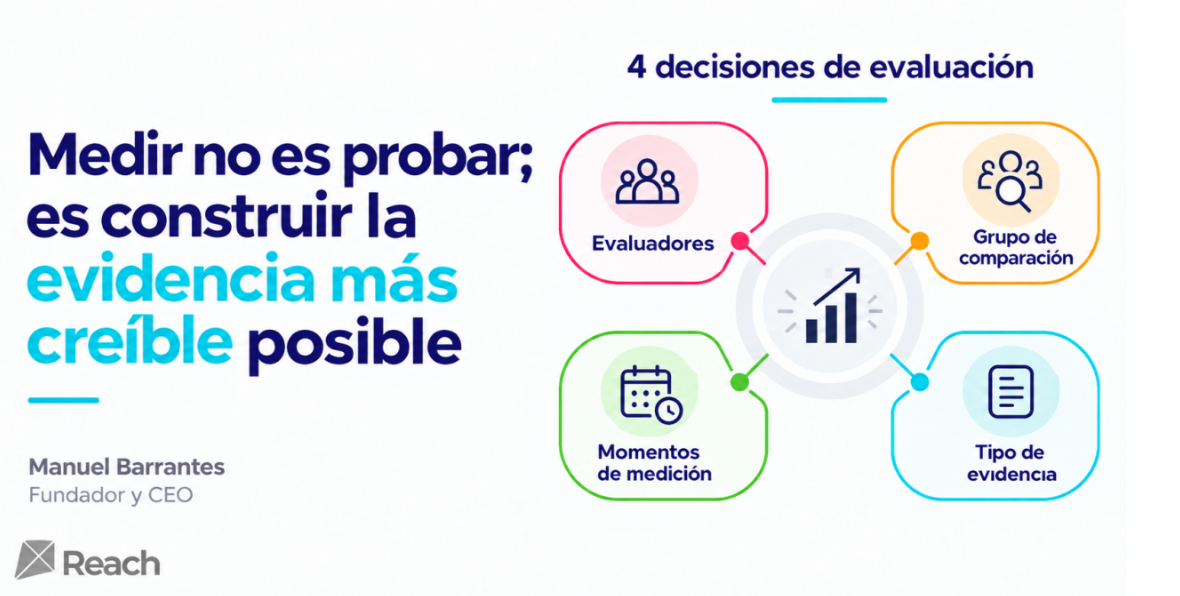
Tomando como referencia la categoría de evaluación del marco de Geerts, usualmente ordeno esta conversación con cada cliente en cuatro decisiones, no en una sola pregunta:
- Evaluadores: ¿quién más, además del propio participante, puede reportar si hubo cambio? (gerente directo, pares, o ambos.)
- Grupo de comparación: ¿existe un equipo o una cohorte similar que no participará del programa en este ciclo, con quien contrastar la evolución?
- Momentos de medición: ¿se está midiendo antes, al cierre, y de nuevo varios meses después? Dos mediciones diferencian un cambio de una tendencia; tres permiten distinguir un efecto pasajero de uno sostenido.
- Tipo de evidencia: ¿se está combinando al menos un dato objetivo (un indicador de negocio) con uno subjetivo (una percepción de cambio), en lugar de depender de uno solo?
Ninguna de estas cuatro decisiones elimina la incertidumbre sobre la causalidad por si solas. Todas la reducen y según la calidad de su abordaje, llegan a ser evidencias sólidas en comités de dirección para la sostenibilidad o ampliación de los procesos de desarrollo de nuestros líderes.
Un ejemplo ilustrativo
Consideremos una empresa minera que busca reducir la tasa de incidentes reportables entre los equipos de supervisores de primera línea, sabiendo que esa tasa también depende de factores ajenos al programa como la antigüedad del equipo, condiciones de la operación, época del año (una operación en época de lluvia es más compleja que en temporada seca por ejemplo). En lugar de resignarse a medir solo participación o aprendizaje, el equipo de Talento decide comparar la evolución de dos turnos con perfiles similares (uno que participa del programa y otro que lo hará en una siguiente edición y así, recoger observación del jefe directo además de la auto percepción del participante y volver a mirar el indicador tres y seis meses después. El resultado no es una prueba absoluta de causalidad, pero sí una evidencia considerablemente más sólida que una encuesta de satisfacción al cierre o un ratio de asistencias.
Tres principios prácticos
- Cambiar el estándar de «prueba» por el de «evidencia sólida»: ningún programa de liderazgo va a producir una demostración de causalidad perfecta; sí puede producir una evidencia muy sólida si se diseña para ello.
- Sumar al menos un evaluador adicional al autorreporte: la percepción de un jefe directo o de un par cambia sustancialmente el peso de la evidencia frente al negocio.
- Medir tres veces, no dos. Una línea base y un cierre muestran que algo cambió; un seguimiento posterior muestra si ese cambio se sostuvo.
Para cerrar
La objeción de aquel director de Talento no tenía una respuesta que la hiciera desaparecer, y no debería tenerla: la dificultad de aislar el impacto de un programa de liderazgo es real. Lo que cambia con esta evidencia es el tipo de conversación que se puede tener a partir de ahí y pasar de «no vale la pena medir porque no podemos probarlo todo» a «diseñemos la evidencia más sólida que sea razonable construir, sabiendo de antemano sus límites».
Nota: este enfoque de diseño y evaluación se trabajará con mayor profundidad en el bootcamp presencial del 14 de octubre en Lima, donde cada participante podrá construir el blueprint de su propio programa, incluida su estrategia de medición. Más información en el perfil de REACH HR Group .
Referencias
- Geerts, J. M. (2024). Maximizing the impact and ROI of leadership development: A theory- and evidence-informed framework. Behavioral Sciences, 14(10), 955. https://doi.org/10.3390/bs14100955